Rapportages spreken elkaar tegen
Teams gebruiken andere bronnen, definities of peilmomenten voor dezelfde indicator.

We brengen data uit systemen, bestanden en databases gecontroleerd samen, zodat processen en rapportages met dezelfde definities en actuele informatie werken.
Klant-, order- en procesgegevens staan vaak verspreid over applicaties, databases, bestanden en externe platformen.
Een klantnummer, status of productcode kan in ieder systeem een andere structuur of betekenis hebben. Alleen technisch verbinden is dan niet voldoende.
Data-integratie maakt afspraken over herkomst, betekenis, kwaliteit en actualiteit. Daardoor ontstaat bruikbare data voor processen, rapportages, digitale toepassingen en verdere automatisering.
We bepalen bijvoorbeeld hoe een klant in twee administraties wordt herkend, welke bron een adres bijhoudt en wanneer een orderstatus dezelfde betekenis heeft. Daarna vertalen we deze afspraken naar mappings en controles die bij het dagelijkse gebruik passen.
Vanuit Zutphen helpen we organisaties in Gelderland gegevens uit verschillende bronnen bruikbaar te combineren. Bij ProRail in Arnhem verbinden we assetgegevens, gepland onderhoud en informatie van aannemers voor de langetermijnplanning. Bekijk hoe we samenwerken in Zutphen en Gelderland.
Applicaties en bestanden leveren records met eigen codes en definities.
We spreken af wat velden betekenen en hoe dubbelen en afwijkingen worden behandeld.
Processen en rapportages gebruiken de gegevens volgens dezelfde afspraken.
Technische assetdata werd gecontroleerd en gestructureerd zodat dezelfde informatie bruikbaar werd voor planning en scenarioanalyse.
Teams gebruiken andere bronnen, definities of peilmomenten voor dezelfde indicator.
Medewerkers corrigeren ontbrekende waarden, dubbele records en afwijkende coderingen.
Exports en samenvoegingen houden een belangrijk proces of dashboard draaiend.
Wijzigingen worden overschreven of komen niet bij alle afnemers terecht.
Iedere nieuwe applicatie vraagt opnieuw om losse mappings en uitzonderingen.
Fouten worden pas zichtbaar in een rapportage of operationeel vervolgproces.
We beginnen niet bij techniek, maar bij de betekenis en het gebruik van gegevens. Wie maakt de data aan, welk systeem is leidend en welke processen vertrouwen erop?
Daarna leggen we definities, relaties en kwaliteitsregels vast. Een status of klantrecord wordt zo niet alleen verplaatst, maar inhoudelijk correct vertaald.
Tot slot bepalen we hoe snel wijzigingen nodig zijn, hoe historische data wordt behandeld en wat er gebeurt wanneer informatie ontbreekt of niet aan de regels voldoet.
Een betrouwbare gegevensstroom bestaat uit meer dan ophalen en doorsturen. Iedere stap maakt expliciet wat met de data gebeurt.
Data wordt via API’s, bestanden, databases of gebeurtenissen uit de bron opgehaald.
Structuur, verplichte waarden, relaties en toegestane coderingen worden gecontroleerd.
Formaten en definities worden vertaald naar een gezamenlijk datamodel.
Gevalideerde data gaat naar processen, rapportages, applicaties of een dataplatform.
Een concrete gegevensstroom vormt het vertrekpunt. We maken de inhoudelijke afspraken toetsbaar voordat we deze in de verwerking uitwerken.
Per gegeven leggen we vast waar het ontstaat, wie de inhoud beoordeelt en welke toepassing het gebruikt. Een leidende bron kiezen we per veld of gegevenstype: het systeem voor een factuuradres kan bijvoorbeeld anders zijn dan dat voor een afleveradres.
We beschrijven hoe bronvelden, codes, statussen en relaties op elkaar aansluiten. Ook verschillen in datumformaat, eenheden en lege waarden krijgen een expliciete vertaling, zodat dezelfde verwerking herhaalbaar blijft.
We selecteren met betrokken medewerkers representatieve gegevens en afwijkende situaties. Daarmee toetsen we verplichte velden, toegestane waarden, relaties en de herkenning van dubbele records.
We leggen vast hoe wijzigingen doorwerken en wie afwijkingen behandelt. Ook bepalen we wanneer een record opnieuw mag worden verwerkt en hoe bronwijzigingen en aangepaste regels worden getest.
Een klant kan met verschillende nummers in twee systemen staan. Om te bepalen of het dezelfde relatie is, onderzoeken we welke kenmerken daarvoor bruikbaar zijn. Een overeenkomst in naam is op zichzelf nog geen voldoende reden om records automatisch samen te voegen.
We spreken af welke combinaties een betrouwbare match vormen en wanneer een medewerker beslist. Bij ontbrekende informatie bepalen we welke verwerking door kan gaan en welke gegevens eerst moeten worden aangevuld. Zo sluiten de controles aan op het doel: voor een verzending zijn andere velden noodzakelijk dan voor een managementrapportage.
Afwijkingen krijgen een herkenbare status, een verantwoordelijke en een afgesproken vervolgstap. Na correctie toetsen we of de gegevens opnieuw kunnen worden verwerkt en of die verwerking aansluit op wat al in het ontvangende systeem staat.
Data-integratie gaat hier over de betekenis en verwerking van gegevens. Wil je die gegevens herbruikbaar beschikbaar maken voor meerdere toepassingen, dan lees je bij Dataplatformen meer over de inrichting van een centrale gegevenslaag. Voor data-integratie is zo’n platform niet altijd nodig.
Synchroniseer relaties tussen CRM-, ERP- en servicesystemen.
Combineer orders, statussen en financiële gegevens.
Lever consistente data aan rapportages en stuurinformatie.
Voorzie workflows van actuele en gevalideerde informatie.
Breng gegevens samen in een centrale datahub.
Verrijk interne data met informatie van partners en registraties.
Persoonlijk contact
Laat je telefoonnummer of e-mailadres achter. Ilja neemt binnen één werkdag persoonlijk contact met je op. In het eerste gesprek bespreken we je vraag, de huidige situatie en een passende eerste stap.
Data-integratie kan bronnen ontsluiten via API’s, databases, bestanden en cloudservices. We kiezen per datastroom de kleinste betrouwbare technische oplossing.
Daarbij combineren we ervaring met operationele systemen zoals Exact met relationele databases en Google Cloud API’s.
Goede data-integratie maakt duidelijk waar een gegeven vandaan komt, welke bewerkingen zijn uitgevoerd en welke records aandacht vragen.
Per gegeven is duidelijk welke bron en welke proceseigenaar leidend zijn.
Afwijkende formaten, ontbrekende waarden en ongeldige relaties worden vroeg herkend.
Mappings en transformaties zijn reproduceerbaar en uitlegbaar.
Foutieve records verdwijnen niet, maar worden gecontroleerd hersteld of aangeboden.
Alleen noodzakelijke data wordt verwerkt en gericht beschikbaar gesteld.
Volumes, verwerkingstijden, fouten en achterstanden worden structureel bewaakt.
We brengen systemen, bestanden, databases, eigenaren en afnemers in kaart.
We onderzoeken definities, relaties, kwaliteit, historie en volumes in de werkelijke data.
We bepalen leidende bronnen, mappings, validaties en het gewenste synchronisatiemoment.
We bouwen extracties, transformaties en gecontroleerde verwerking van uitzonderingen.
We testen representatieve records, grensgevallen, volumes en herstel na fouten.
We monitoren datastromen en verbeteren regels wanneer bronnen of processen veranderen.
Voor Proflebo verbindt de Data Hub Orthomatic, Exact en SIGVARIS. De gegevens moeten niet alleen aankomen: ze worden gecontroleerd en vertaald voor de volgende stap in de orderverwerking. Dit laat zien waarom betekenis en kwaliteitsregels bij de koppeling horen.
Bij de financiële langetermijnplanning voor ProRail combineerden we interne assetgegevens met gepland onderhoud en informatie van aannemers over uitgevoerd onderhoud. Deze bronnen beschrijven verschillende aspecten van hetzelfde onderhoudsproces. Door ze in samenhang te beoordelen ontstaat beter inzicht in vervanging en de gegevenskwaliteit waarop de planning steunt.
De inhoudelijke vraag verschilt per organisatie. Daarom bespreken we met de betrokken medewerkers welke gegevens vergelijkbaar zijn, welke bron waarvoor leidend is en welke verschillen nadere beoordeling vragen.


Een Data Hub verbindt Orthomatic, Exact en SIGVARIS en verwerkt circa 98% van ongeveer 20.000 orders per jaar automatisch.
Bekijk case

Technische assetdata en rekenregels komen samen in maatwerksoftware voor financiële langetermijnscenario’s.
Bekijk caseDeze expertise wordt ingezet binnen verschillende diensten van AioriQ.
Lees verder over technische expertises die hier direct op aansluiten.
Verdiep je in de keuzes, randvoorwaarden en aanpak die bij dit vraagstuk horen.
Vertaal volledigheid, juistheid en actualiteit naar toetsbare regels en eigenaarschap.
Lees het inzicht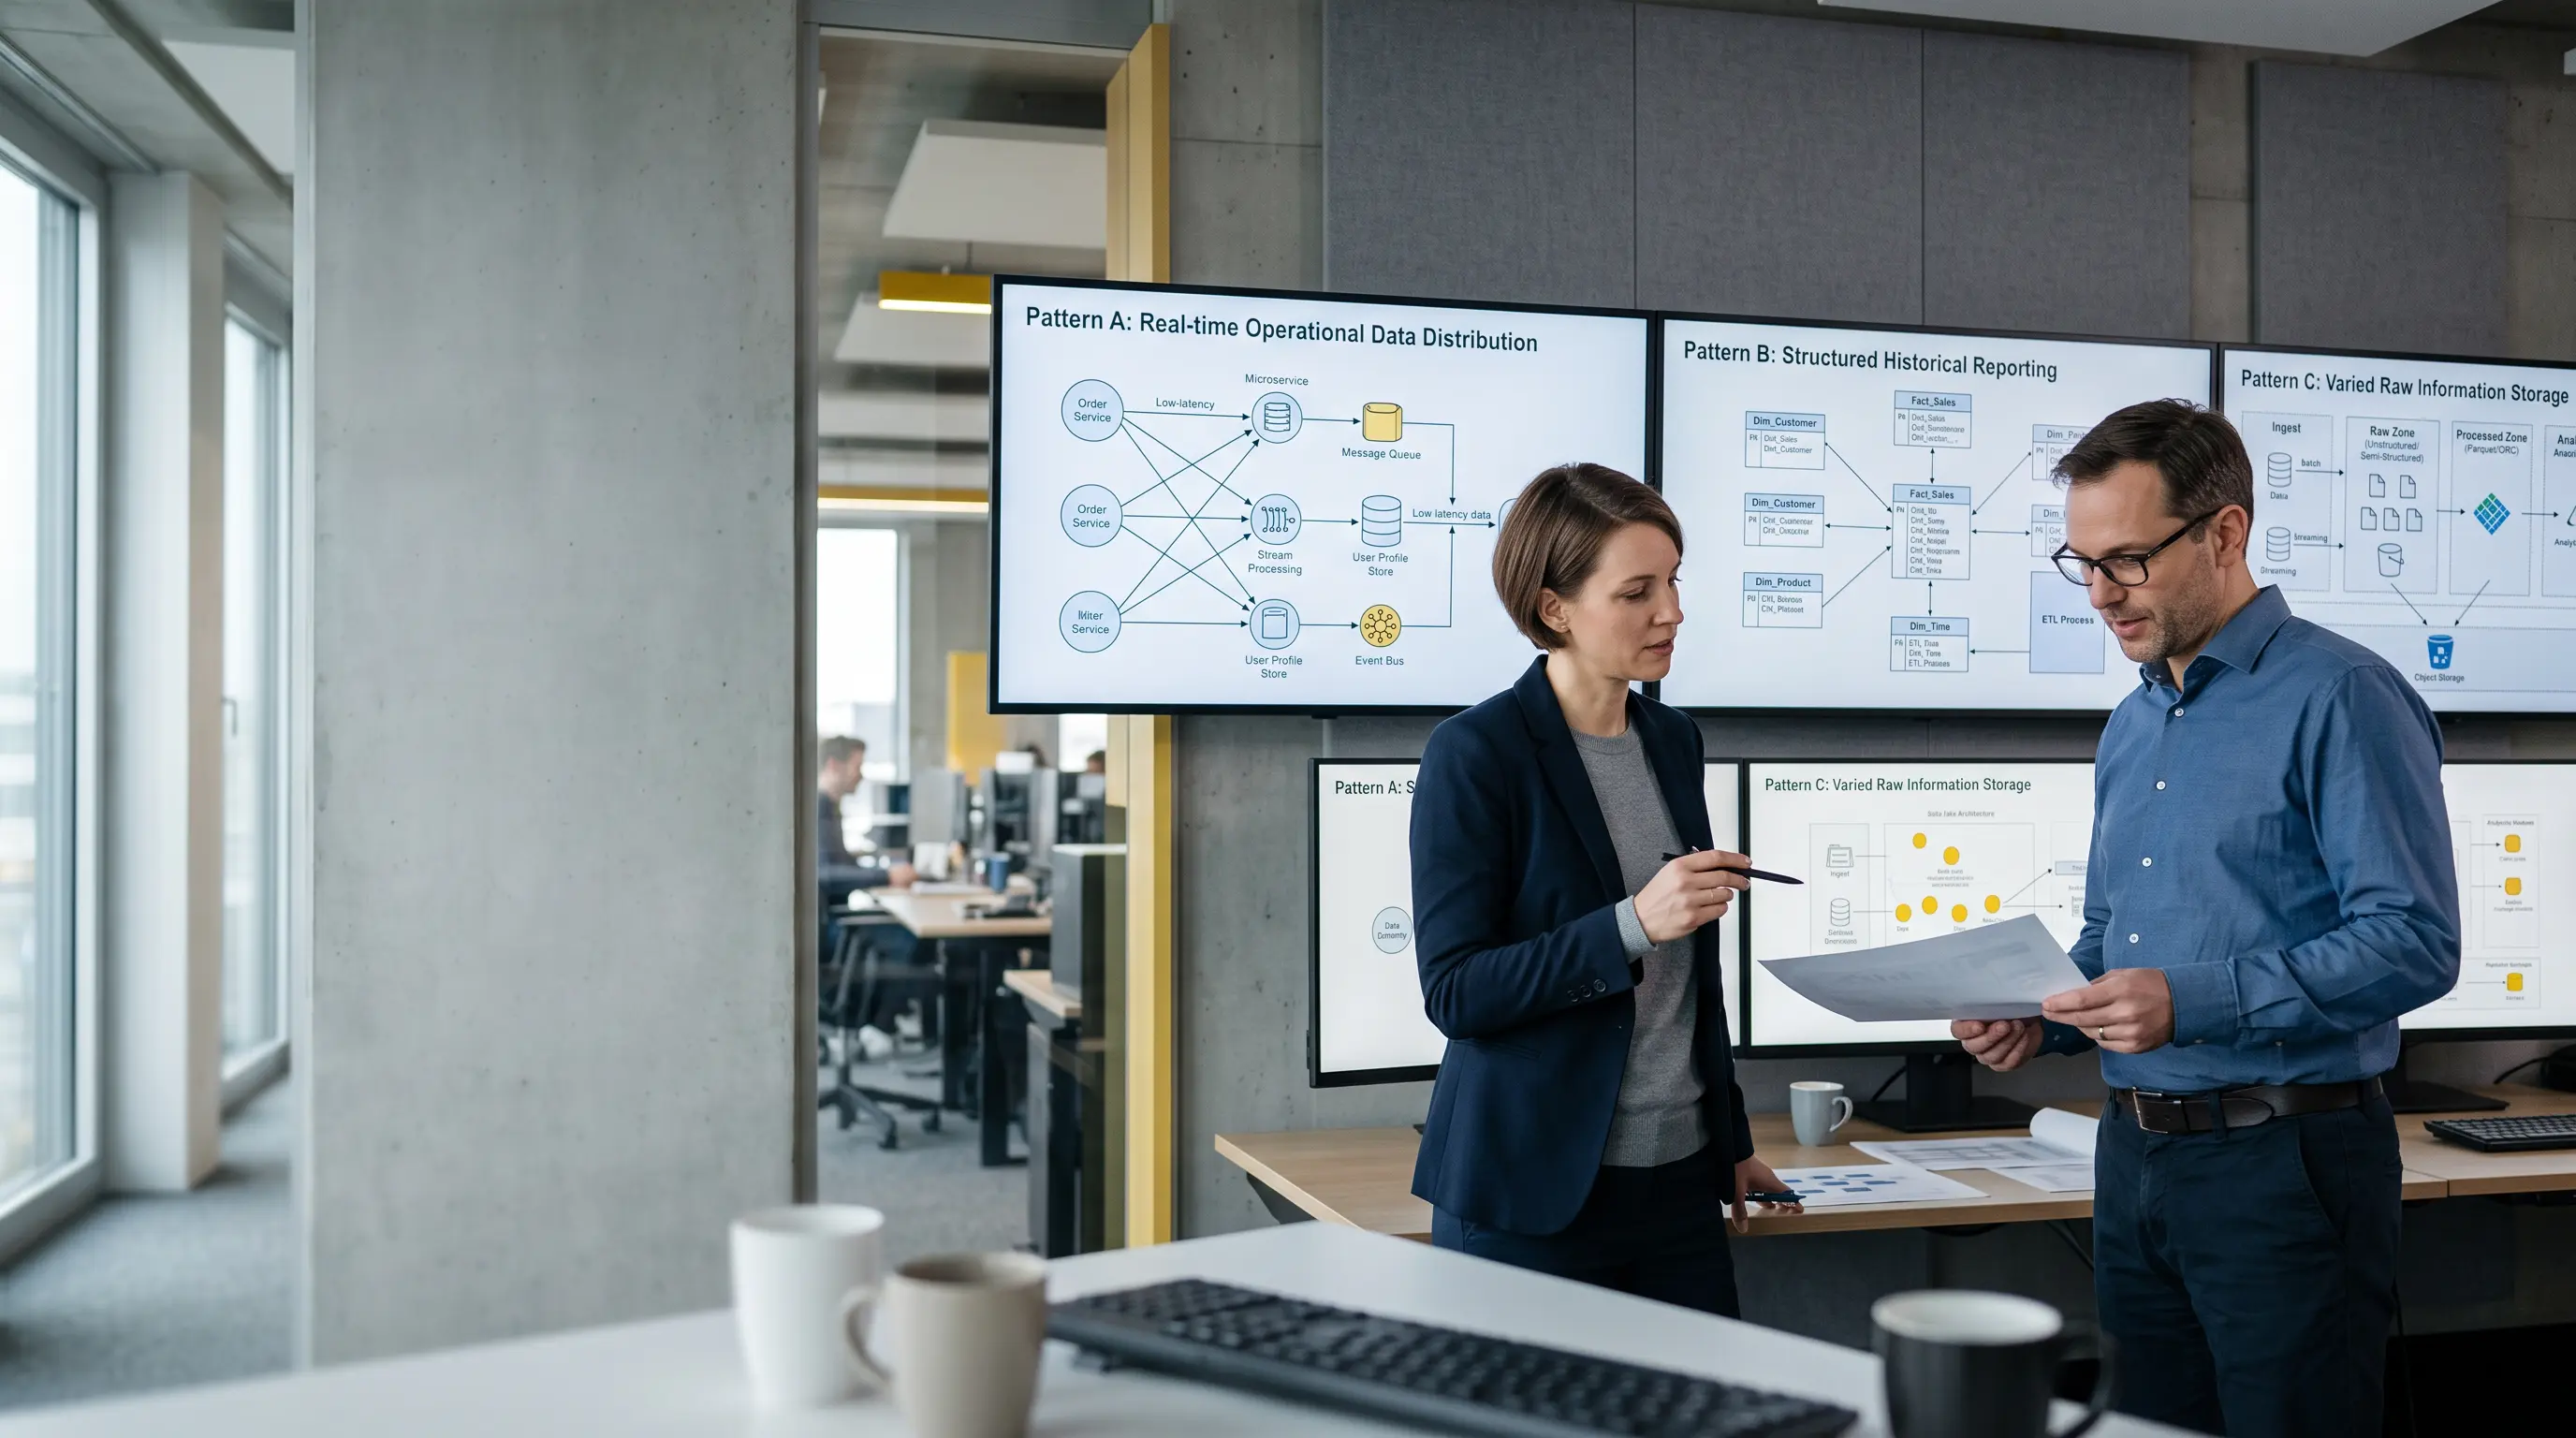
Vergelijk de verschillende doelen en vormen van centrale gegevensverwerking.
Lees het inzichtData-integratie is het samenbrengen, vertalen en synchroniseren van gegevens uit verschillende bronnen.
Systeemintegratie richt zich op applicaties en processen. Data-integratie legt meer nadruk op betekenis, kwaliteit en transformatie van gegevens.
Niet altijd. Data kan rechtstreeks worden uitgewisseld of tijdelijk en centraal worden verwerkt.
Met controles op verplichte velden, formaten, dubbele records, relaties en toegestane waarden.
Ja. Terugkerende exports, samenvoegingen en controles kunnen vaak worden geautomatiseerd.
Dat kan realtime, periodiek of op basis van gebeurtenissen. De keuze hangt af van het proces.
Afwijkingen worden gelogd, opnieuw aangeboden of zichtbaar gemaakt voor correctie.
Ja. Interne informatie kan worden verrijkt met gegevens van partners, leveranciers of openbare registraties.
Bij ETL wordt data vóór opslag getransformeerd. Bij ELT wordt brondata eerst geladen en daarna binnen het doelplatform verwerkt. De juiste keuze hangt af van het gebruik, volume, platform en de gewenste herleidbaarheid.
Ja. We kunnen bestaande exports, scripts en integraties analyseren, documenteren en stapsgewijs verbeteren of vervangen.
Dat spreken we af per gegeven of veld, samen met de inhoudelijk verantwoordelijke medewerkers. We bekijken waar het gegeven wordt aangemaakt en bijgewerkt, waarvoor het wordt gebruikt en welke bron daarvoor geschikt is. Deze afspraken leggen we vast in de mapping en verwerking.
Alleen wanneer daarvoor duidelijke en geteste herkenningsregels zijn afgesproken. Bij twijfel maken we de mogelijke overeenkomst zichtbaar voor beoordeling. Zo blijft een samenvoeging gebaseerd op de betekenis van de gegevens en het betrokken proces.
Welke gegevens wil je tussen systemen laten aansluiten? Bespreek met Ilja de bronnen, de betekenis van velden en wat medewerkers met de uitkomsten moeten kunnen doen.
Samen verkennen we een eerste gegevensstroom en de afspraken over mapping, kwaliteit en correctie. Zo krijgt de integratie een concreet en toetsbaar vertrekpunt.
Liever zelf een moment kiezen? Plan een kennismaking bij Calendly.